
昨天把 MCP 的 JSON-RPC 訊息拆開來看,知道 initialize、tools/call 這些訊息實際長什麼樣。
但還有一個問題:
這些 JSON-RPC 訊息,到底怎麼從 Client 送到 Server?
MCP 目前主要有兩種傳輸方式:
stdio
Streamable HTTP
差別不只是「一個走本機、一個走網路」。
真正會影響的是 Server 怎麼部署、狀態放在哪裡,以及多個 Client 要怎麼連它。
今天用同一個 counter Tool 跑幾組實驗,直接看差異。
先看最熟悉的 stdio。
Host 啟動一個 MCP Server 子行程,往它的 stdin 寫 JSON-RPC,再從 stdout 收回結果。
可以先把它想成:
Host
  │
  ├── stdin  ──→ MCP Server
  │
  └── stdout ←── MCP Server
這次我同時建立兩個 Client,各自啟動一個 Server,再各呼叫兩次 counter。
結果:
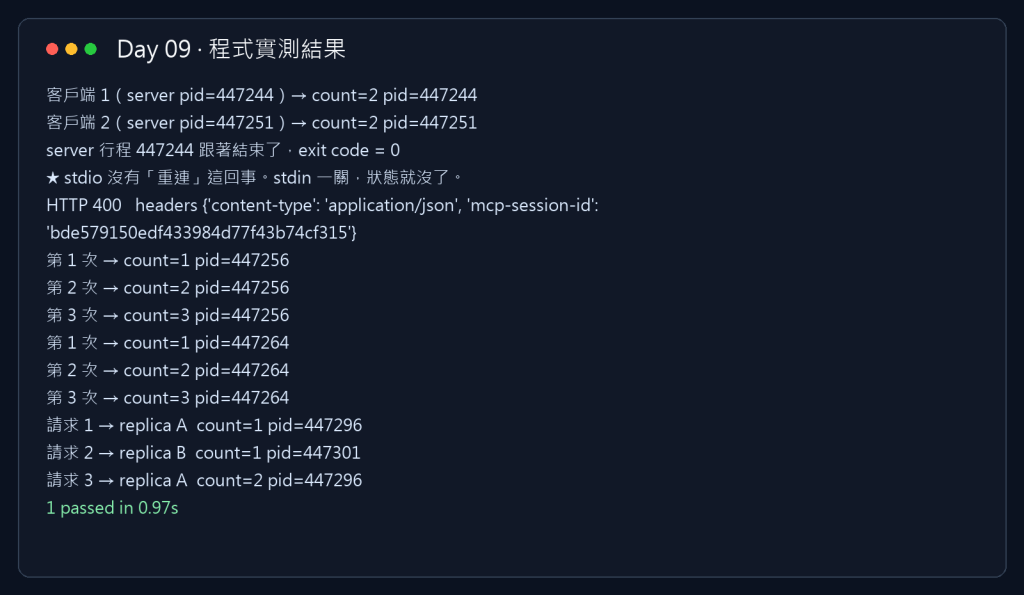
客戶端 1(server pid=447244)→ count=2 pid=447244
客戶端 2(server pid=447251)→ count=2 pid=447251
兩邊的 count 都是 2,但 PID 不同。
原因很直接:它們根本是兩個不同的 Server 行程。
所以行程裡的記憶體也是各自獨立的。
接著把第一個 Server 的 stdin 關掉:
server 行程 447244 跟著結束了,exit code = 0
對 stdio 來說,Client 和 Server 的生命週期綁得很緊。
連線結束,行程通常也跟著結束,存在行程記憶體裡的狀態自然就消失。
這很適合 Claude Code 這類本機工具:簡單、不需要開 Port,也可以直接沿用本機作業系統的權限。
但如果 Server 要提供給多人共用,或部署成遠端服務,就不會是 stdio 最擅長的場景。
換成 Streamable HTTP 後,Tool 本身完全不用改:
@mcp.tool()
def counter() -> str:
    _state["count"] += 1
    return f"count={_state['count']} pid={os.getpid()}"
差別只在啟動方式:
mcp.run(
    transport="streamable-http",
    host="127.0.0.1",
    port=8931,
)
這時 Server 不再是某一個 Client 專屬的子行程,而是一個可以獨立運行的 HTTP 服務。
Client 透過:
POST /mcp
送 JSON-RPC 訊息。
也就是昨天看到的:
{
  "jsonrpc": "2.0",
  "id": 1,
  "method": "initialize"
}
內容沒變,只是今天換了一條路送出去。
先跑有狀態模式。
Client 完成 initialize 後,Server 的回應 Header 會帶回:
Mcp-Session-Id
例如:
mcp-session-id: bde579150edf433984d77f43b74cf315
後續請求要帶著這個 Session ID。
我故意不帶 Session 就直接呼叫 Tool:
HTTP 400
接著帶上同一個 Session,連續呼叫三次:
第 1 次 → count=1 pid=447256
第 2 次 → count=2 pid=447256
第 3 次 → count=3 pid=447256
這裡最重要的不是 count,而是三次請求可以被 Server 視為同一個 Session 的後續操作。
所以有狀態 HTTP 可以把多次 HTTP Request 串成同一段 MCP Session。
如果部署多個 replica,而且 Session state 只存在單一行程裡,就要再處理 sticky session,或把 Session state 放到共享儲存。
接著把 Server 改成:
stateless_http=True
這次 initialize 不再取得 Mcp-Session-Id,後續 Request 也不需要攜帶 Session。
看起來很合理。
結果連叫三次 counter:
第 1 次 → count=1 pid=447264
第 2 次 → count=2 pid=447264
第 3 次 → count=3 pid=447264
等等。
不是無狀態嗎?
為什麼 count 還在累加?
問題出在這裡:
_state = {"count": 0}
_state 是 Python 行程裡的全域變數。
stateless_http=True 拿掉的是 MCP 協定層的 Session,不會幫你清掉程式自己存在記憶體裡的資料。
所以:
協定無狀態 ≠ 程式自動無狀態
這個差別很重要。
單一 Server 行程很容易讓人誤以為「反正 count 還是會保存」。
所以這次直接開兩個無狀態 replica,模擬負載平衡器輪流送 Request:
請求 1 → replica A  count=1 pid=447296
請求 2 → replica B  count=1 pid=447301
請求 3 → replica A  count=2 pid=447296
請求 4 → replica B  count=2 pid=447301
問題馬上出現。
使用者明明送了四次請求,但:
replica A 認為自己收到 2 次
replica B 也認為自己收到 2 次
因為兩台機器根本不知道對方記憶體裡有什麼。
這不是 MCP 的問題,而是應用程式把狀態放錯地方。
如果要做真正可以水平擴充的無狀態服務,跨 Request 需要共享的資料就不能只放在:
_state = {}
而要移到例如:
Redis
Database
其他共享儲存
這樣 Request 打到哪一台 replica,都能看到同一份狀態。
整理成一張表:
| stdio | HTTP 有狀態 | HTTP 無狀態 | |
|---|---|---|---|
| Server 型態 | Client 啟動的行程 | 獨立 HTTP 服務 | 獨立 HTTP 服務 |
| Session | 跟著行程 | MCP Session | 不保存 MCP Session |
| 多 Client | 通常各自一個行程 | 可以 | 可以 |
| 水平擴充 | 不是主要使用場景 | 需處理 Session state | 最容易擴充 |
| 常見場景 | 本機工具 | 有連續互動狀態的服務 | API / 高併發服務 |
我的判斷方式會很簡單。
如果 MCP Server 要操作使用者本機的檔案、Git repository 或開發環境:
→ stdio
如果是遠端服務,而且一次互動需要跨 Request 保留 Session:
→ Streamable HTTP,有狀態
如果希望任何 replica 都能處理任何 Request:
→ Streamable HTTP,無狀態
但這時應用程式自己的共享狀態也要一起外置。
所以選 transport,其實也是在選部署方式。
第一個是 Accept Header。
Streamable HTTP Client 要能處理:
Accept: application/json, text/event-stream
如果只寫:
Accept: application/json
這次實測會收到 406。
有趣的是,curl 沒手動指定 Accept 時通常會送:
Accept: */*
反而可以通過。
所以會出現一個很怪的情況:
curl 可以,自己寫的 Client 不行。
第二個是 SSE。
如果回應的 Content-Type 是:
text/event-stream
就不能直接:
resp.json()
要先從 SSE 裡取出:
data: {...}
再解析裡面的 JSON。
昨天我們把 MCP 的 JSON-RPC 訊息攤開來看。
今天補上最後一塊:
JSON-RPC 決定「訊息長什麼樣」
Transport 決定「訊息怎麼送過去」
而 stdio 跟 Streamable HTTP 的差異,最後其實都會回到同一件事:
你的 MCP Server 準備跑在哪裡?
明天進入 Day 10。
前面幾天都是把 MCP 一層一層拆開,接下來把它們組回去:用 Python SDK 寫出第一個真正可以掛進 Claude Code 的 MCP Server。


 iThome鐵人賽
 看影片追技術